SERVICIO · CULIACÁN Y REMOTO
Scraping web y extracción de datos públicos
Mucha información útil para decidir —precios de la competencia, catálogos, listados, publicaciones— está en la web pero dispersa y sin un formato que puedas analizar. Desarrollo extractores con Python que la recolectan de forma periódica, la limpian y te la entregan lista en Excel, CSV, una base de datos o un panel.
Te sirve si…
- Revisas a mano sitios de la competencia para comparar precios o productos.
- Necesitas una base de datos de listados públicos para analizar un mercado.
- Quieres un reporte periódico con información que hoy copias de varias páginas.
- Tienes un proceso de investigación que depende de consultar los mismos sitios cada día.
Qué recibes
- Revisión de viabilidad: fuentes, términos de uso, frecuencia y volumen.
- Extractor en Python con manejo de errores, reintentos y límites de velocidad.
- Limpieza y normalización de datos (precios, fechas, categorías, duplicados).
- Entrega en Excel, CSV, Google Sheets, base de datos o API.
- Ejecución programada y aviso cuando una fuente cambia de estructura.
Cómo trabajo
- 01
Viabilidad
Reviso cada fuente: si los datos son públicos, qué permiten sus términos y robots.txt, y si existe una API oficial que convenga más.
- 02
Prototipo
Extraigo una muestra para validar contigo que los campos y el formato sirven para tu análisis.
- 03
Producción
Construyo el extractor completo, con limpieza, control de errores y la periodicidad acordada.
- 04
Mantenimiento
Los sitios cambian; el sistema avisa cuando una fuente deja de responder igual para ajustarla.
Qué necesito de ti
- La lista de sitios o fuentes y los campos que necesitas.
- Para qué usarás los datos, para elegir formato y frecuencia.
- El destino final: hoja de cálculo, base de datos o sistema propio.
Lo que conviene saber
- Solo extraigo información pública y respetando los términos de cada sitio; no hago extracción de datos personales ni evado inicios de sesión o protecciones.
- Si un sitio cambia su estructura, el extractor necesita ajustes.
- Algunas fuentes bloquean la extracción automática; en ese caso propongo alternativas como APIs oficiales.
Problemas que resuelvo con este servicio
Monitoreo de precios de la competencia
Recolecta precios públicos de otros sitios de forma periódica y recibe cambios en un reporte claro.
Leer solución →Extraer listados inmobiliarios para análisis de mercado
Reúne ofertas públicas de propiedades en una base de datos limpia para analizar precios por zona.
Leer solución →Seguimiento de precios agrícolas de fuentes públicas
Concentra precios de mercados y fuentes oficiales en un solo tablero para decidir cuándo vender o comprar.
Leer solución →Trabajo relacionado
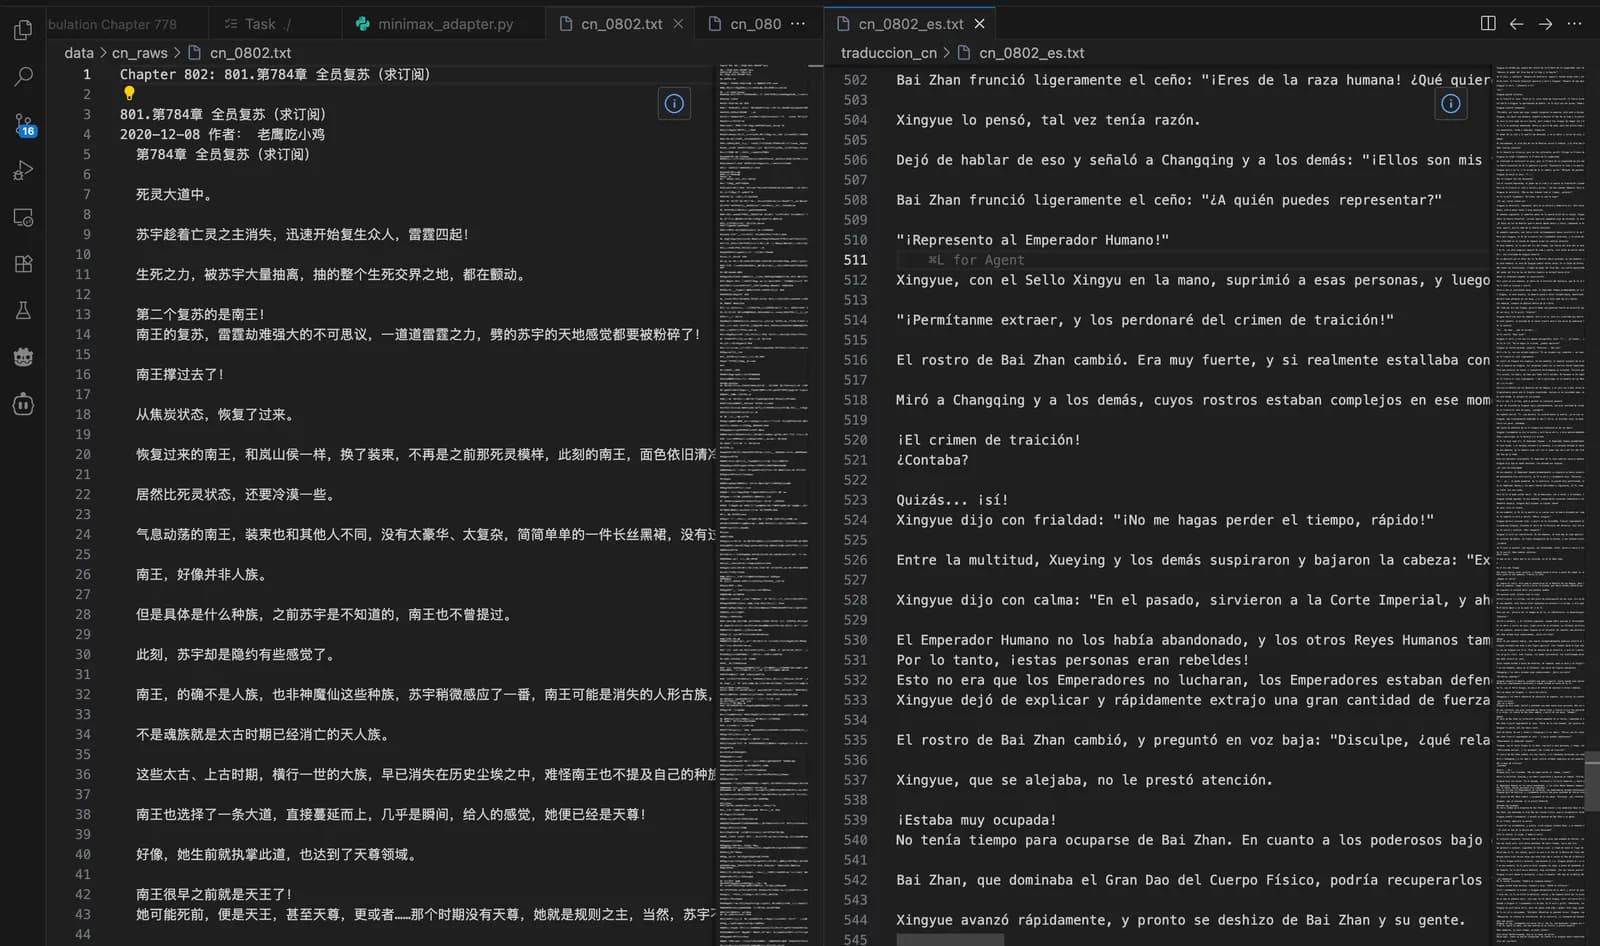
NLP Pipeline
Extracción y traducción multi-modelo de contenido web, con procesamiento por lotes y control de consistencia.
Ver caso →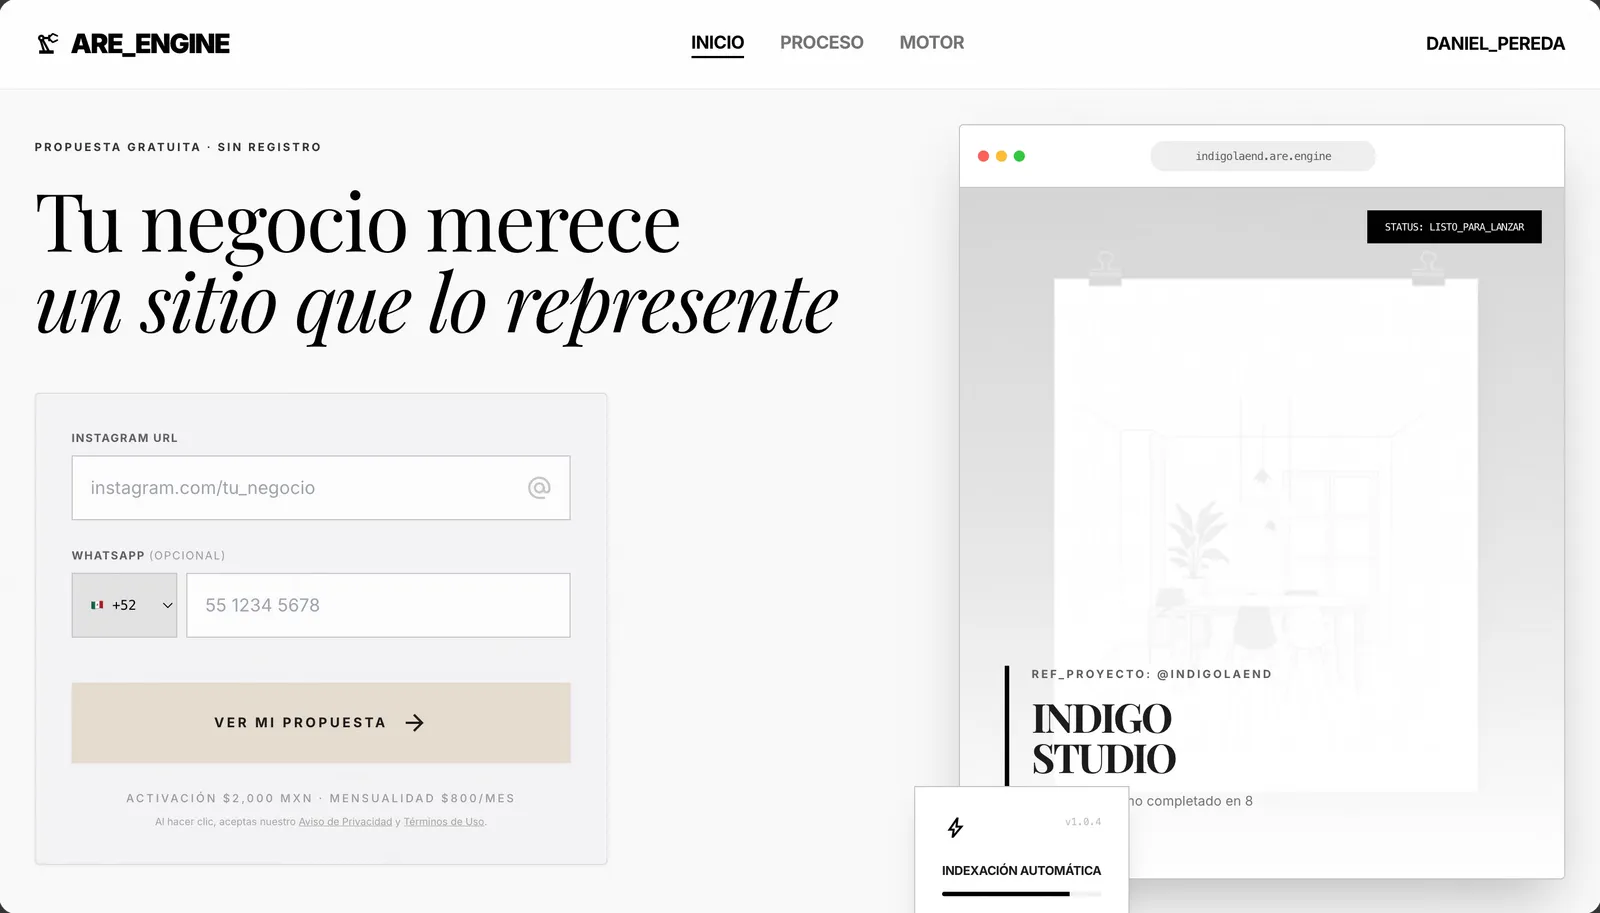
ARE Engine
Un motor que conecta análisis de marca, generación de contenido y construcción de sitios para negocios locales.
Ver caso →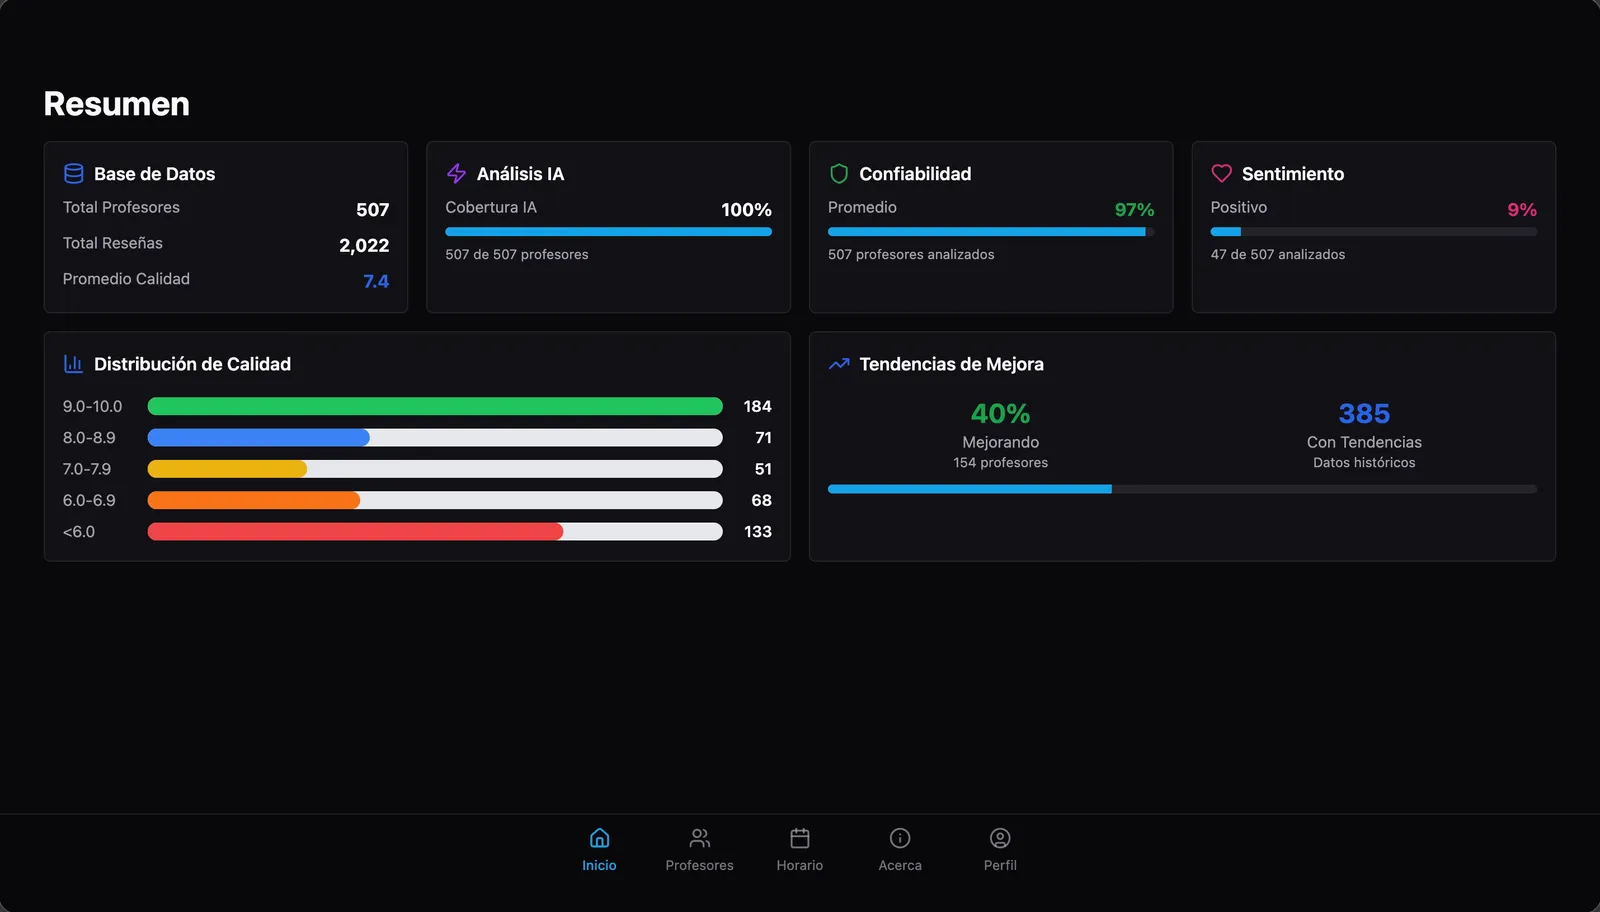
EvaluaProf
Ingesta, normalización y análisis de evaluaciones académicas para convertir respuestas en información útil.
Ver caso →Para decidir con más información
Preguntas frecuentes
¿El scraping es legal?
Extraer información pública y no personal suele ser aceptable, pero depende de los términos de cada sitio y del uso que se dé a los datos. Reviso cada fuente antes de empezar y descarto las que lo prohíben.
¿Cada cuánto se actualizan los datos?
Lo que tu análisis necesite: una vez, diario, semanal o en tiempo casi real. Una frecuencia más alta implica más carga en las fuentes y más infraestructura.
¿En qué formato recibo la información?
En el que uses: Excel, CSV, Google Sheets, una base de datos PostgreSQL o un panel con filtros.
¿Cuánto cuesta un proyecto de scraping?
Depende del número de fuentes, de su complejidad técnica (páginas dinámicas, paginación, bloqueos) y de la frecuencia. Una extracción única es más sencilla que un monitoreo continuo.
¿Lo platicamos?
Cuéntame qué necesitas resolver. Te respondo con preguntas concretas, un alcance posible y el siguiente paso, sin compromiso.